Vectiq AIaaS - GPU Cloud & MLOps Dạng Dịch Vụ
GPU cloud đa tenant đang phát triển: mỗi khách hàng có namespace riêng, huấn luyện GPU qua hàng đợi, fine-tune LoRA, serving bằng Triton và tính phí theo giờ GPU
Tổng quan
Vectiq AIaaS là dịch vụ chúng tôi đang xây để cho thuê năng lực GPU kèm bộ công cụ MLOps xung quanh, để khách hàng huấn luyện, fine-tune và serving model lớn mà không phải tự vận hành cluster.
Khi tạo một tenant, hệ thống cấp namespace Kubernetes kèm RBAC và NetworkPolicy, volume lưu trữ, bucket object storage, danh tính trên Keycloak và chỗ trong hàng đợi GPU của Kueue, rồi tự gỡ lại nếu có bước thất bại; hiện các tenant dùng chung một hàng đợi, hạn mức GPU riêng cho từng tenant đang được phát triển.
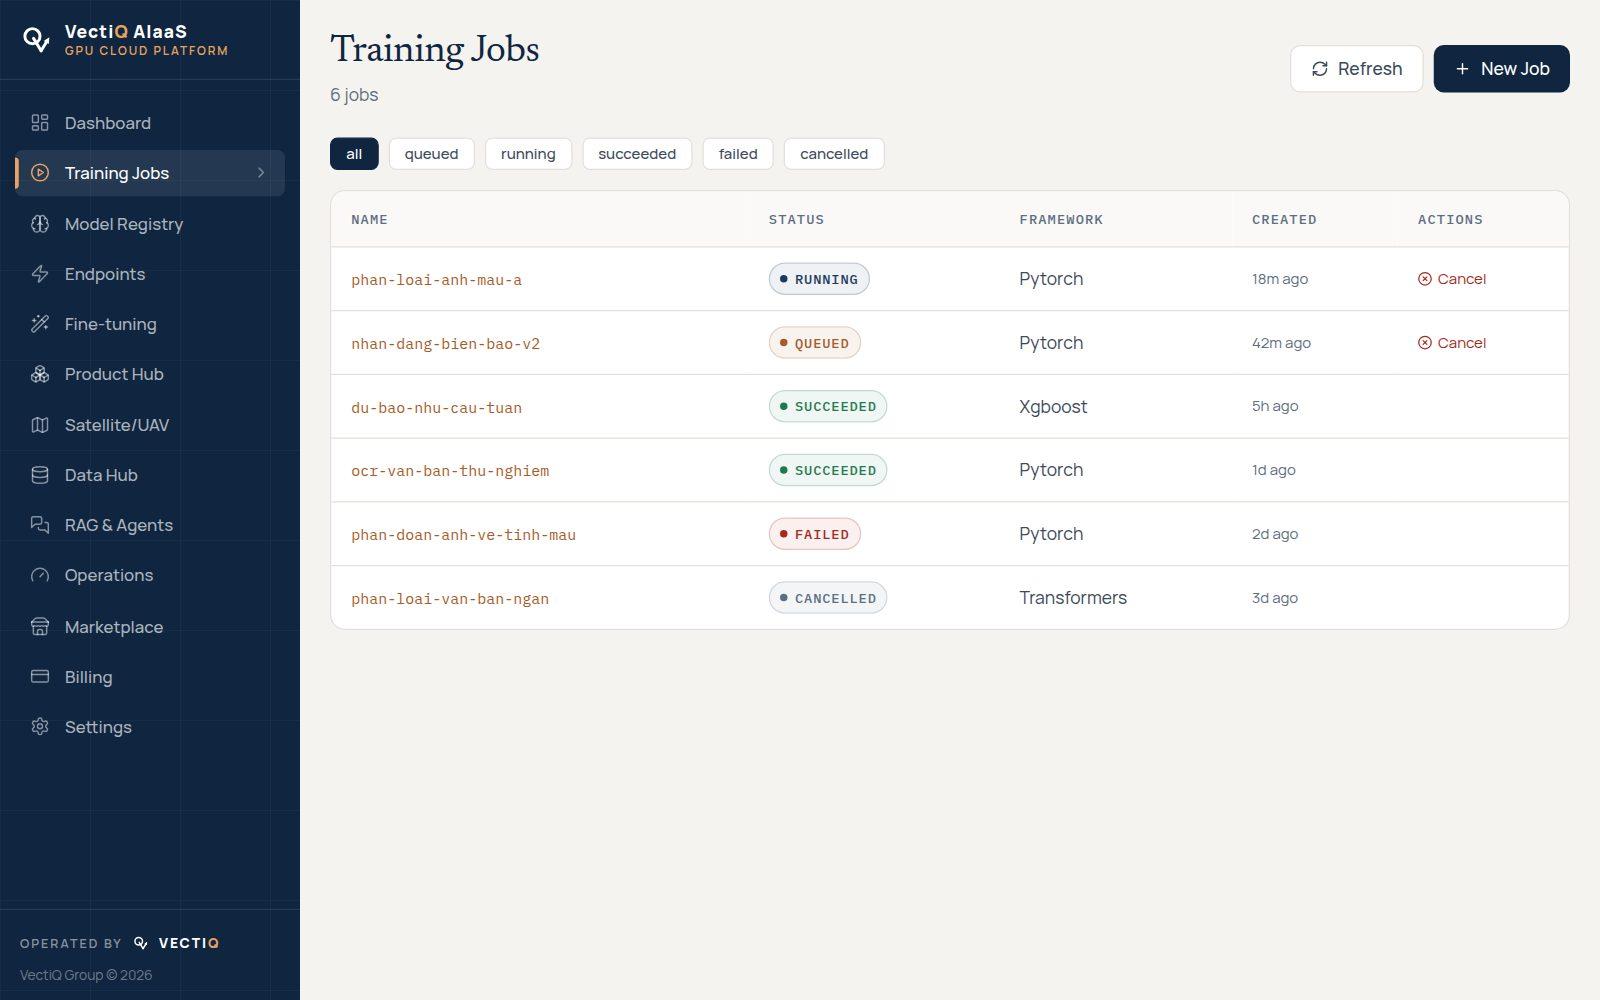
Job huấn luyện được gửi thành Kubernetes Job, xin trọn một GPU hoặc một lát MIG của A100; job fine-tune mang cấu hình LoRA/QLoRA; model sau khi train được chép vào model repository của Triton và phục vụ từ deployment riêng của tenant.
Model registry kiểm tra artifact, smoke test trên Triton và hiệu năng so với version production hiện tại trước khi promote, còn service billing đo giờ GPU, lượt suy luận và dung lượng lưu trữ để lập hóa đơn. Tám service và portal đã chạy cùng nhau trên môi trường local; nền tảng chưa được triển khai lên cluster GPU, vì vậy đang để ở trạng thái sắp ra mắt.