01
Dataset Có Phiên Bản & Kết Nối Dữ Liệu
Tải lên CSV, Parquet hoặc kéo bảng từ Iceberg, Parquet trên S3, PostgreSQL, MySQL. Mỗi lần kéo tạo một phiên bản dataset bất biến, ghi lại snapshot nguồn, và thay đổi schema được báo ngay.
02
Huấn Luyện Giữ Nguyên Bước Tiền Xử Lý
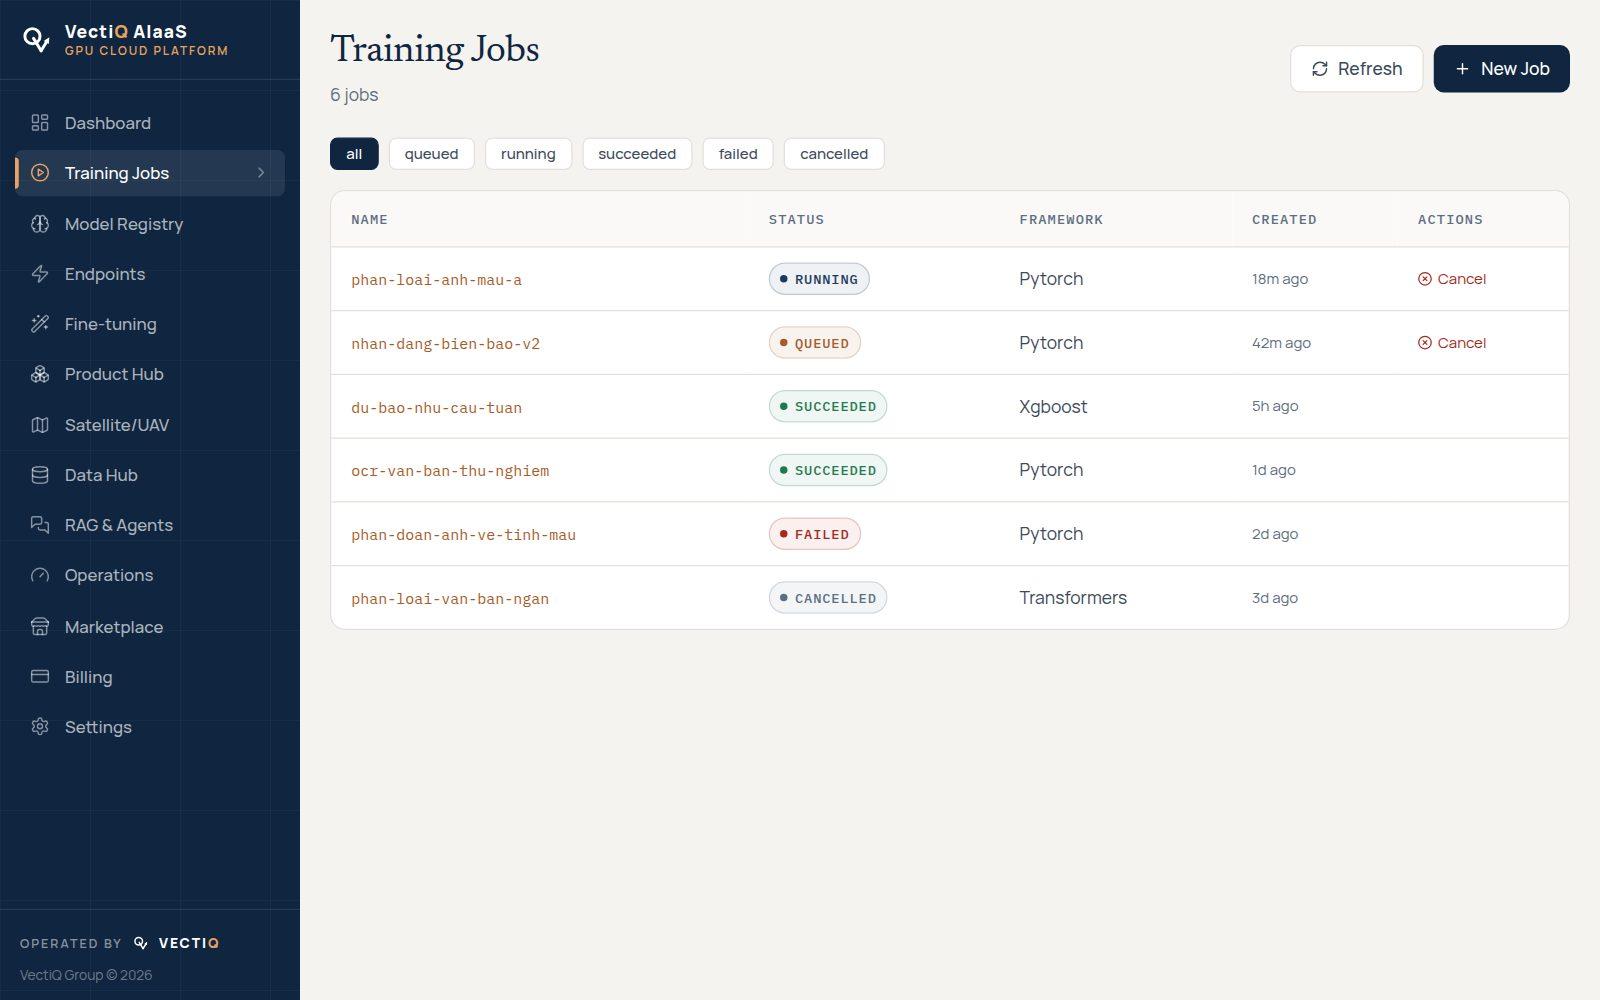
Job chạy trên worker Celery, xem log trực tiếp. Bước điền thiếu, mã hóa và chuẩn hóa chỉ fit trên tập train rồi lưu cùng estimator, theo dõi bằng MLflow; có thể bật tìm siêu tham số bằng Optuna.
03
Model Registry Có Quality Gate
Một version chỉ lên production khi vượt ngưỡng accuracy, R² hoặc mIoU theo loại bài toán. Mỗi model chỉ có một version production, có thể bắt buộc người thứ hai duyệt, và mọi version đều có model card tự sinh.
04
Endpoint, Canary & Shadow
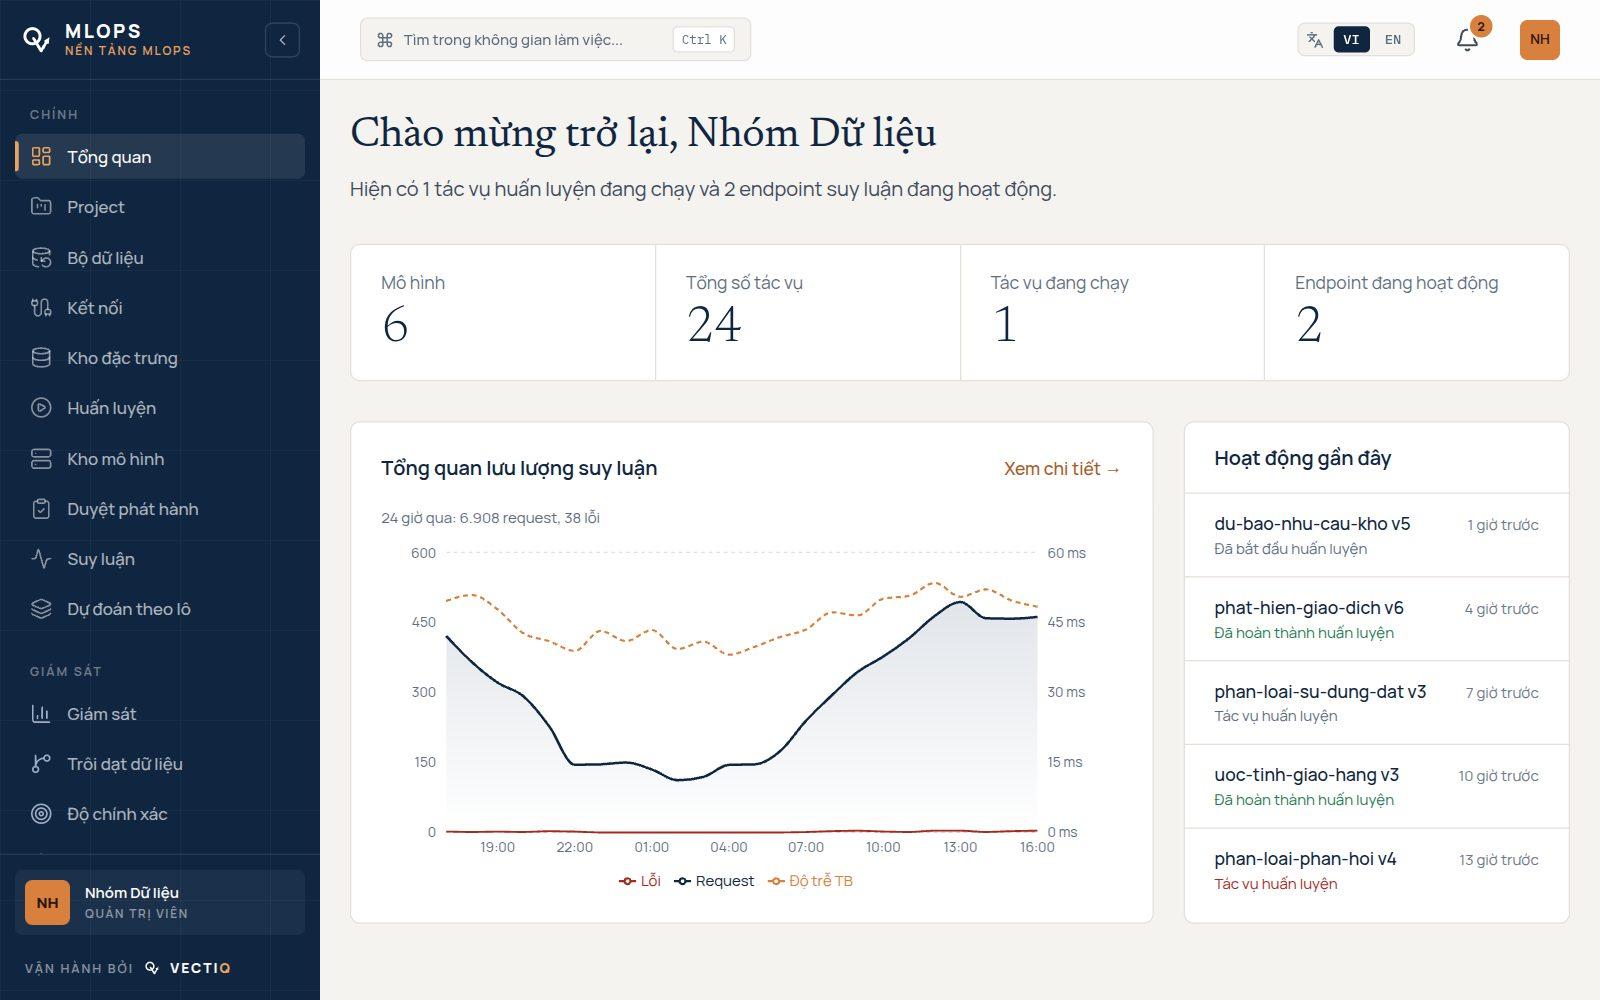
Triển khai một version sau API key có rate limit riêng. Chia một phần traffic sang version mới, sao chép request sang version shadow mà không ảnh hưởng kết quả trả về, hoặc rollback bằng một lệnh gọi.
05
Giám Sát Drift & Độ Chính Xác
Mỗi lần deploy có một baseline lấy từ dữ liệu train; dữ liệu thật được so bằng PSI. Nhãn thực tế gửi về được tổng hợp thành báo cáo độ chính xác, còn luật cảnh báo gửi tới Slack, email, webhook hoặc hộp thông báo trong ứng dụng.
06
Vòng Train Lại Tự Động
Retrain policy kích hoạt khi có drift, độ chính xác giảm hoặc theo lịch. Model mới được chấm trên cùng tập holdout với model đang chạy; kém hơn thì dừng và ghi lý do, tốt hơn thì sang canary và chờ duyệt.
07
Feature Store
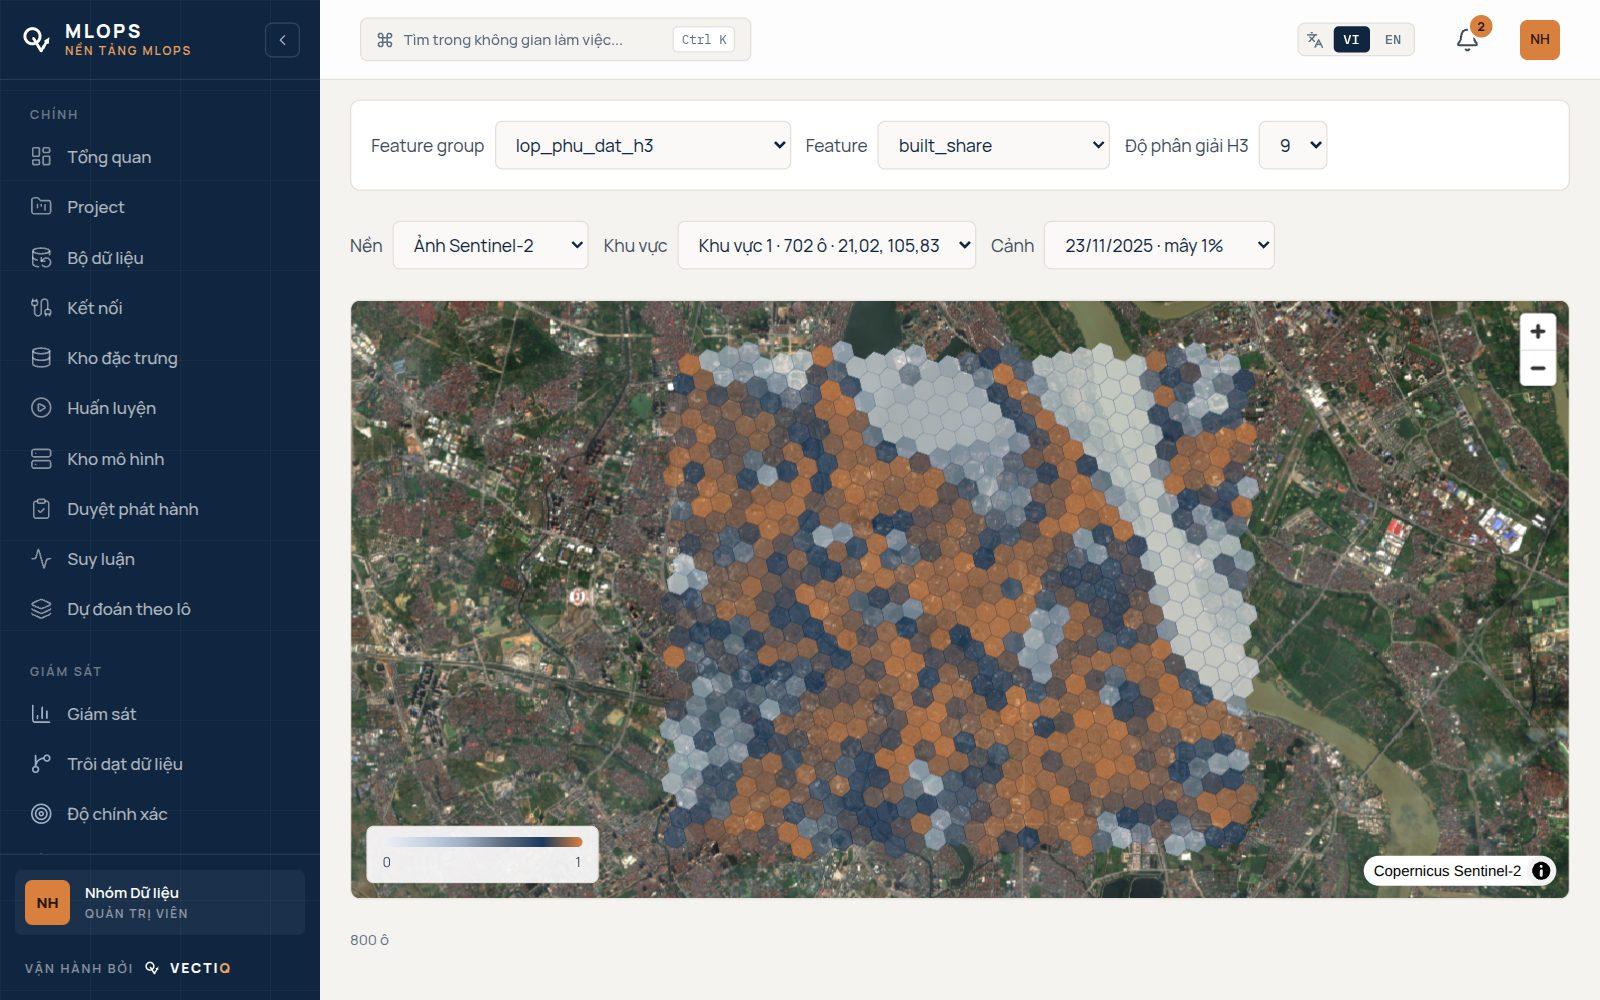
Nạp dữ liệu có kiểm định vào online store trên Redis và offline store trên Parquet, tra cứu point-in-time để dựng tập train, và endpoint tự lấy feature theo entity id thay vì bắt phía gọi gửi lên.
08
Phân Quyền, Nhật Ký & SDK
Phân quyền theo project, personal access token, SDK Python kèm CLI, API client giới hạn phạm vi cho đối tác, và nhật ký ai đã đổi gì. Dashboard có tiếng Việt và tiếng Anh.