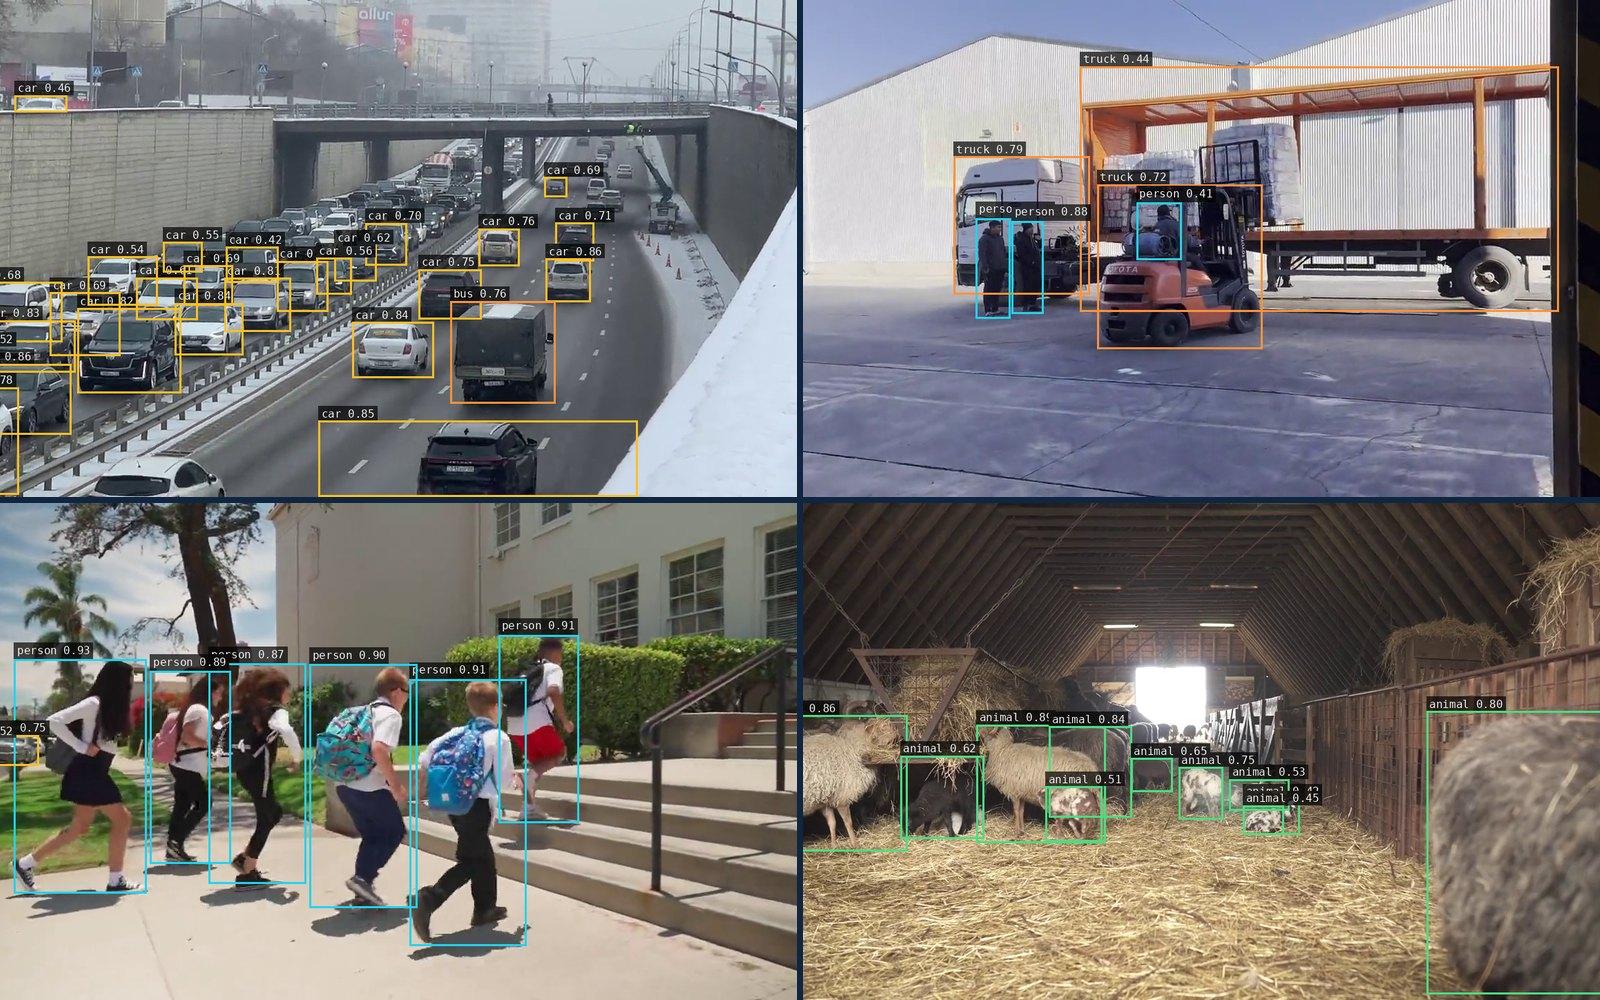
Xây Dựng Pipeline Thị Giác Máy Tính Real-time Quy Mô Lớn
Việc xử lý đồng thời luồng video RTSP thông lượng cao từ hàng chục camera IP công nghiệp đòi hỏi những lựa chọn kiến trúc cực kỳ cẩn thận. Trong ghi chép kỹ thuật này, chúng tôi sẽ chia sẻ cách đạt được độ trễ dưới 30ms cho mỗi khung hình trên các thiết bị Edge phần cứng như NVIDIA Jetson Orin Nano.
1. Bộ Đệm Bộ Nhớ Zero-Copy
Các pipeline bắt hình OpenCV truyền thống thường sao chép khung hình từ bộ nhớ thiết bị CUDA sang bộ nhớ CPU host, sau đó lại chép ngược vào bộ nhớ GPU để mô hình TensorRT suy luận. Quá trình truyền tải bộ nhớ qua lại (host-device transfer) này thường gây ra độ trễ khoảng 10-15ms cho mỗi khung hình 1080p.
# Tối ưu hóa chia sẻ bộ nhớ CUDA giữa PyTorch / TensorRT
import torch
import cupy as cp

# Chia sẻ trực tiếp con trỏ bộ nhớ mà không cần qua CPU
cuda_stream = torch.cuda.Stream()
with torch.cuda.stream(cuda_stream):
    tensor_input = torch.as_tensor(gpu_frame_ptr, device="cuda")
    output = tensorrt_engine(tensor_input)
2. Chiến Lược Bỏ Khung Hình Thích Ứng
Khi xử lý luồng video 30 FPS cho hệ thống an toàn công nghiệp (ví dụ: giám sát tuân thủ đồ bảo hộ PPE), việc xử lý trọn vẹn từng khung hình là không cần thiết:
- Giai đoạn Phát hiện (Detection Phase): Tốc độ 5 FPS là quá đủ để phát hiện một người bước vào khung hình.
- Giai đoạn Theo dõi (Tracking Phase): Thuật toán ByteTrack có thể chạy với chi phí tính toán CPU rất nhẹ để làm mượt các hộp giới hạn (bounding boxes) qua các khung hình bị bỏ trống.
Chia sẻ bộ nhớ Zero-copy đòi hỏi phải có kiến trúc bộ nhớ hợp nhất (UMA) như trên NVIDIA Jetson hoặc Apple Silicon, nơi CPU và GPU cùng chia sẻ chung một bus RAM vật lý.
Luôn cấp phát trước bộ nhớ pin cho CUDA stream trong giai đoạn khởi động (startup) thay vì cấp phát động các tensor trên từng khung hình để tránh hiện tượng nghẽn do quá trình dọn dẹp rác bộ nhớ (garbage collection).
Đã thử nghiệm trên Jetson Orin Nano 8GB: 16 luồng RTSP camera động được xử lý ở tốc độ 6 FPS với độ trễ suy luận toàn trình (end-to-end) dưới 22ms.
Bài Học Rút Ra: Việc giảm tốc độ khung hình cho quá trình phát hiện từ 30 FPS xuống 6 FPS giúp giảm tải tính toán GPU lên tới 80% mà hoàn toàn không làm giảm độ chính xác khi phát hiện các sự kiện an toàn.